빅데이터종합설계(캡스톤디자인) · 중간과제 발표

모델은 그대로,
하네스만 AI가 고쳤다

50문항에서 본 'AI 오답 노트의 역효과'는
212문항 검증에서 재현되지 않았다
박재현 (경제학)  ·  2026.11.02
01 · 질문

같은 모델, 같은 문제인데 점수가 다르다

아무것도 기억하지 않을 때
64%
학습 예시 60개를 전부 보여 줄 때
82%

제출본 · validation 50문항 · 모델 가중치는 동일

차이를 만든 것: 하네스(harness)

모델을 둘러싼 코드 전체.
무엇을 기억시키고, 무엇을 보여 주고, 답을 어떻게 받아 내는가.

Meta-Harness (Stanford, 2026): AI가 실패 기록을 읽고 하네스 코드를 스스로 다시 쓴다.

이 루프를 내 서버에서 직접 돌리면,
AI는 어디를 고치고 결과는 어떨까?

Lee et al. (2026) arXiv:2603.280522 / 8
02 · 무엇을 했나

공식 코드를 개인 온프레미스 서버로 옮겨 실제로 돌렸다

① 하네스 실행Qwen이 증상 문장을
22개 질병 중 하나로 분류
② 채점·기록정확도, 오답,
토큰 수를 파일로 남김
③ AI가 읽고 고침Claude Code가 기록을 읽고
새 메모리 코드 3개 작성
④ 다시 채점validation으로 고르고
test로 1회 최종 확인
↺ 반복 · 모델(Qwen)의 가중치·설정은 끝까지 고정
항목설정
과제 모델Qwen3.8-Flash-Next · 개인 DGX Spark
하네스를 고치는 AIClaude Code (sonnet)
데이터Symptom2Disease · 22개 질병
분할train 60 · val 50 · test 212

옮기며 직접 해결한 것

  • 호출당 7초 → 2.9초: 추론 토큰 생성을 끔 (모든 시스템 동일 적용)
  • AI의 모든 권한 허용 옵션 제거 → 작업 폴더 쓰기, 읽기 전용 명령만
stanford-iris-lab/meta-harness · text_classification (MIT)3 / 8
03 · 제출 결과와 반전

AI의 하네스는 점수를 지켰지만, 설계한 장치는 꺼져 있었다

val (50)test (212)입력 토큰
fewshot_all82.0%84.9%144,224
confusion_contrast
AI 작성 · 비슷한 예시 6개
82.0%80.7%28,745

기억 분량 1/7, 입력 토큰 −80%.
test에서는 −4.2%p: 비용과 정확도의 trade-off

그 하네스의 memory.json 속 기록된 오답

0건

공식 코드의 오프라인 학습은 정답을 '예측'으로, 정오를 항상 '맞음'으로 넘긴다. 틀린 기록이 구조적으로 생길 수 없었다.

실제로 작동한 것은 "비슷한 예시 6개만 골라 넣기" 하나.
점수는 맞았지만, 이유는 AI의 설명과 달랐다.

제출본 · 단일 시드(42) · inner_loop.py 145–152행 was_correct = True4 / 8
04 · 후속 실험 1 제출 후 추가

오답 노트를 실제로 켰더니, 50문항에서는 점수가 떨어져 보였다

원시 예시를 보여 줌 LLM이 쓴 문장을 보여 줌
knn_top6비슷한 예시 6개
82%
fewshot_all예시 60개 전부
82%
contrast_online실제 혼동 쌍 예시
82%
reflexion_notes오답마다 성찰 노트
78%
cue_bank_verified검증 후 저장한 단서
74%
cue_bank예시 6개 + 단서
70%
no_memory기억 없음
70%

실제 예측으로 학습하는 온라인 모드로 7개 기억 방식 비교

같은 예시 6개에 LLM 단서만 더하면 82% → 70%

"고열 + 짙은 가래면 폐렴"
→ 천식 환자 3명을 폐렴으로 오답

가설: LLM이 쓴 그럴듯한 단서가
판단을 끌어당긴다

단, 시드 1개 · 50문항. 불일치 7 : 1, 정확 McNemar p = 0.070. 유의하지 않은 경향.
validation 50 · seed 42 · 온라인 모드 별도 실행5 / 8
05 · 후속 실험 2 사전 등록 검증

숫자를 보기 전에 규칙을 고정하고 212문항으로 다시 쟀다

① 사전 등록 커밋가설·검정·판정 규칙을 결과 전에 git에 고정
② test 212문항학습 표본 3종(seed 42·123·456)으로 기억을 새로 만듦
③ 동일 조건 재실행temperature 0에서도 생기는 반복 잡음 측정

knn_top6 − cue_bank 정확도 차 (%p) · 오른쪽 = 단서가 손해

seed 42 · val 50후속 실험 1
+12.0
7:1 · p=.070
seed 42 · test 212같은 기억, 4배 문항
+1.4
13:10 · p=.68
seed 123 · test 212다른 학습 표본
−2.8
5:11 · p=.21
seed 456 · test 212다른 학습 표본
+3.8
17:9 · p=.17

축 범위 ±20%p · 불일치 = knn_top6만 맞힘 : cue_bank만 맞힘 · 정확 McNemar

주 가설 H1 판정 (사전 등록 규칙)

NOT SUPPORTED

세 시드 모두 p ≥ .05, 방향도 엇갈림

시드 통합 불일치 35 : 30 · MH p = .54

  • 원시 예시 계열 vs LLM 문장 계열: 차이 없음 (log-odds 0.02, p=.70)
  • '정답 질병 단서 주입' 효과: 212에서 미확인 (p=.82)
최종 분석 2026-11-02 · 37/37 결과 · 사전 등록 판정 규칙 적용6 / 8
06 · 살아남은 결과

무엇을 기억하느냐보다, 기억이 있느냐가 컸다

knn_top6 vs no_memory · test 212문항 · 학습 표본별 정확 McNemar

학습 표본knn_top6no_memory차이불일치p
seed 4282.5%67.0%+15.6%p43 : 105.6×10⁻⁶
seed 12381.6%67.0%+14.6%p39 : 85.5×10⁻⁶
seed 45684.9%67.0%+17.9%p48 : 104.5×10⁻⁷

세 학습 표본 모두에서 유의 (seed 42는 Holm 보정 후 p = 3.3×10⁻⁵)

시드는 기억에 들어갈 학습 예시를 바꾼다. test 212문항 자체는 세 시드가 같다. 그래서 독립 표본 636개가 아니라 같은 문항의 반복 평가로 본다.

예시 전부 vs 비슷한 6개

fewshot_all 85.8% vs knn_top6 82.5%
3 : 10, p = .09 · 유의차 없음 (seed 42)

입력 토큰 611k vs 116k: 약 1/5

같은 조건, 두 번 실행

50문항 중 4문항(8%)의 정오가 바뀜

제출본 64%와 후속 70%의 차이(3문항)도 이 범위 안

입력 토큰은 test 평가 캐시 기준7 / 8
07 · 배운 것

성능은 하네스가 만들고, 결론은 표본이 만든다

01

하네스 효과는 크고 견고하다

모델 그대로, 비슷한 예시 6개만 기억시켜 +15~18%p. 세 학습 표본 모두 유의.

02

50문항의 경향은 결론이 아니다

7 : 1이던 '단서의 역효과'가 212문항에서 13 : 10, 다른 표본에서는 반대 방향.

03

파일을 열고, 규칙을 먼저 정하라

기억 파일을 열어 꺼진 장치를 찾았고, 사전 등록으로 내 가설을 스스로 재검증했다.

다음 단계

5%p 차이를 검정력 80%로 확인하려면 독립 문항 658개가 필요하다 (불일치율 20% 가정).
이 데이터의 test는 212개뿐이라, 시드를 늘리는 것으로는 부족하고 새 데이터가 필요하다. 추론을 켠 모델과의 대조도 남아 있다.

검정력 계획: 짝지은 McNemar · 양측 α=0.058 / 8
부록 A · 질의응답용

test 212문항, 7개 시스템 (seed 42, 같은 기억을 test에 적용)

시스템정답정확도knn_top6 대비 불일치정확 McNemar pHolm p입력 토큰
no_memory14267.0%43 : 100.00000560.00003356,814
fewshot_all18285.8%3 : 100.0920.461611,406
knn_top617582.5%———115,873
contrast_online17080.2%8 : 30.2270.906162,263
reflexion_notes17582.5%7 : 71.0001.000174,276
cue_bank_verified17683.0%8 : 91.0001.000158,511
cue_bank17281.1%13 : 100.6781.000180,893

불일치 = (knn_top6만 맞힘 : 이 시스템만 맞힘). Holm은 knn_top6 대비 6개 비교 묶음. 입력 토큰은 test 평가 호출의 캐시 기록 합계이며 비용 환산값이 아니다. 유의하지 않은 차이는 '같다'는 뜻이 아니다.

seed 42 · test 212A
부록 B · 한계와 검증 절차

이 결과를 어디까지 믿을 수 있나

한계

  • 세 시드는 같은 test 문항을 재정렬한다. 시드 합산 p값(예: 4.9×10⁻¹⁶)보다 시드별 검정을 근거로 삼았다.
  • 37개 결과 파일 모두 분석에 포함. 결측을 오답으로 채운 값은 없다.
  • 추론을 끈 모델 하나, 데이터셋 하나. 추론 모드나 임상적 인과는 이 결과로 말할 수 없다.
  • 64% vs 70%: 같은 요청 키에서 캐시된 답이 달랐다. 서버 측 원인은 미확인.

검증 절차

  • 사전 등록 문서 해시가 분석 전후 동일
  • 분석 코드는 기존 seed 42 결과 21개 비교·350개 문항 행을 정확히 재현한 뒤에만 새 데이터에 적용
  • 통계 단위 테스트 26개 통과 · 서버 재호출 없이 캐시만 사용
  • 유의성이 나올 때까지 지표·분할·검정을 바꾸지 않음 (부트스트랩 10,000회, 시드 0 고정)
사전 등록 → 패리티 검증 → 캐시 전용 분석B
부록 C · 데이터 시각화 갤러리 (1/4)

파레토 프론티어와 데이터 분할별 재현성
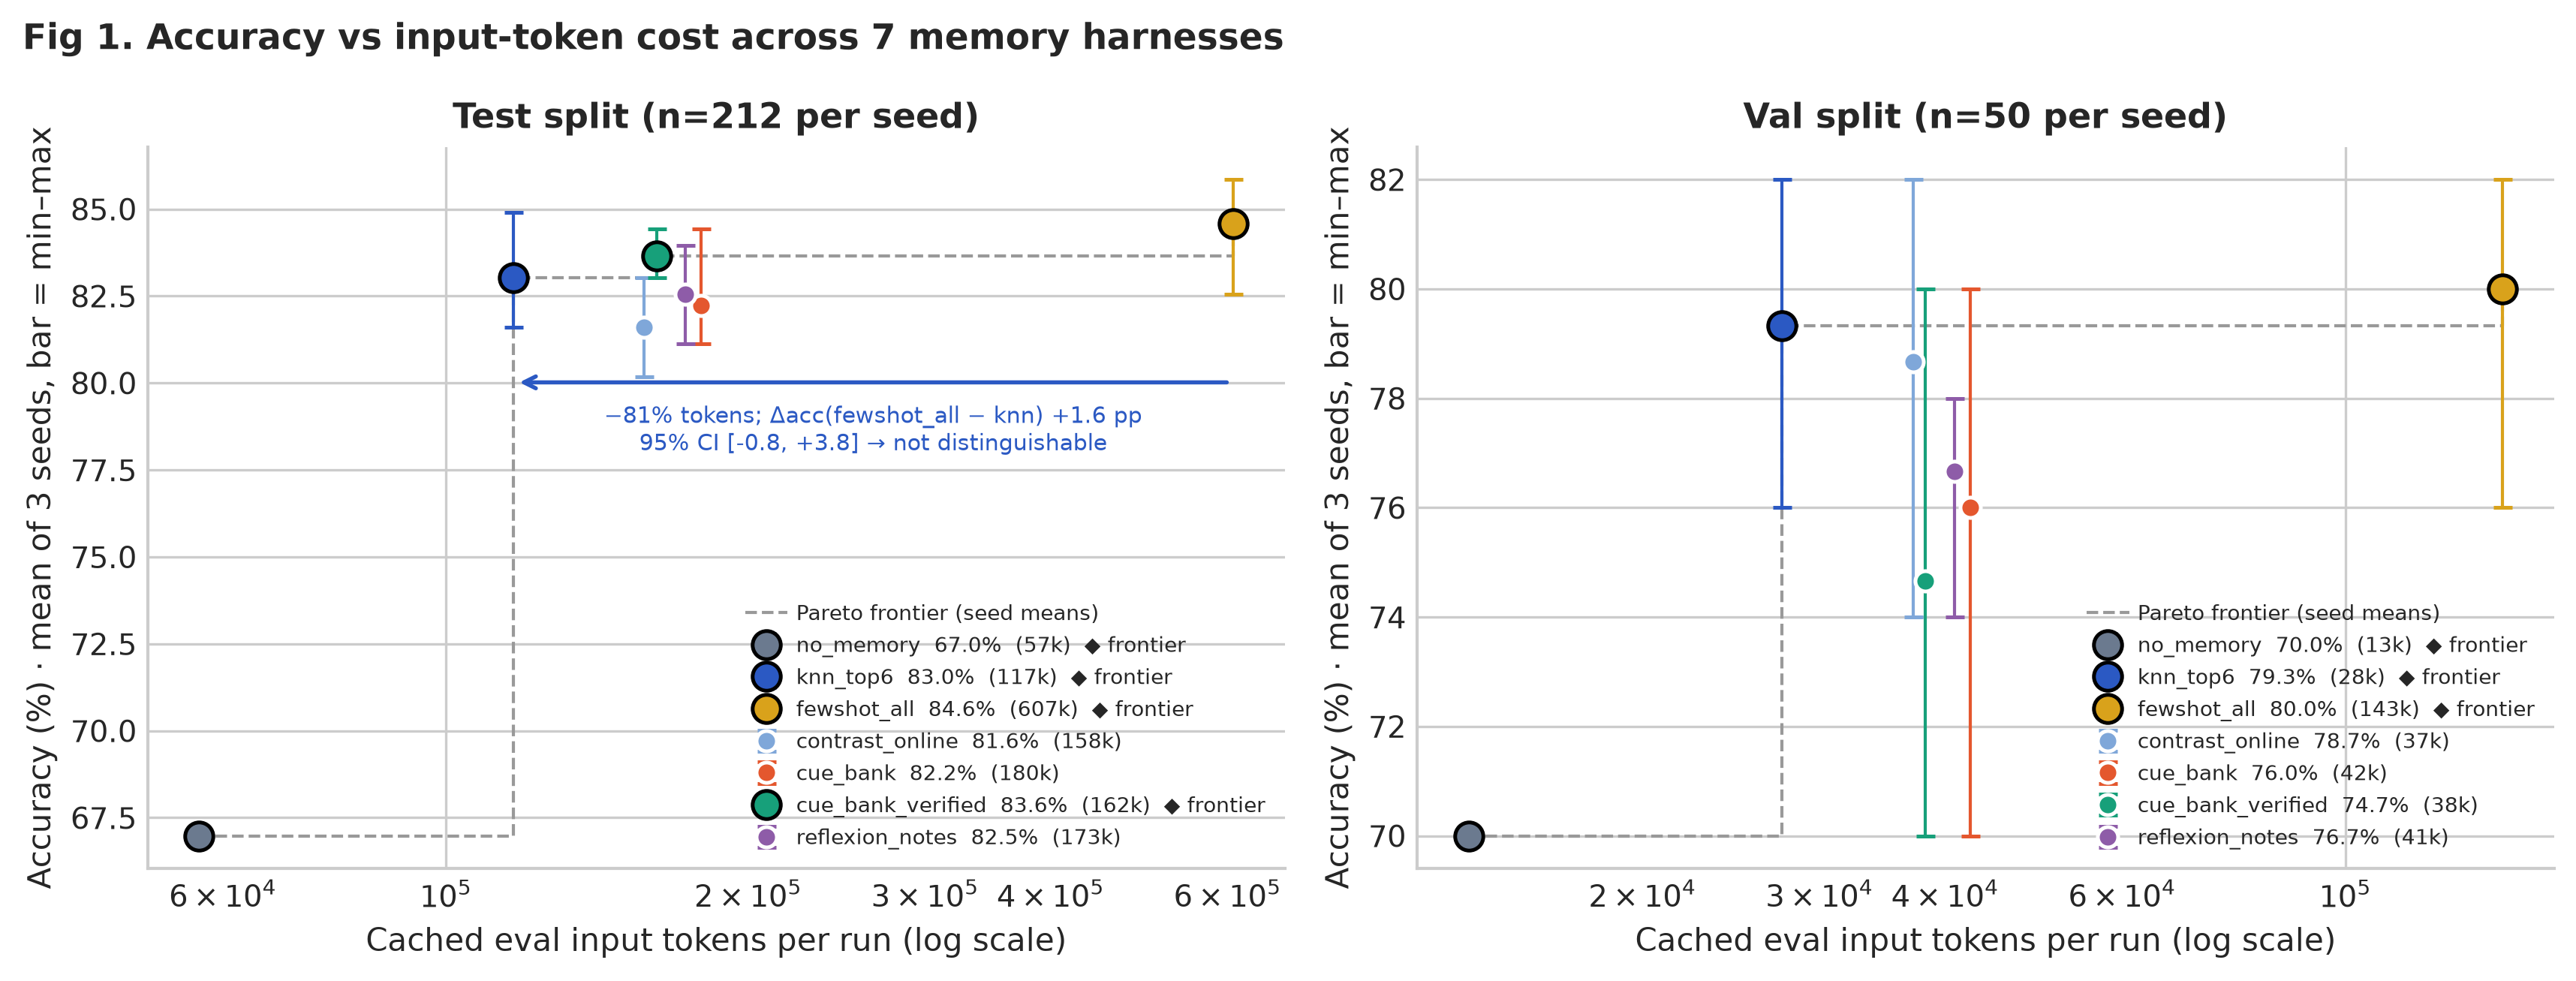
Fig 1: Accuracy vs Tokens Pareto Frontier
Fig 1. 정확도 vs 토큰 비용 파레토 프론티어
knn_top6는 fewshot_all 대비 81% 적은 토큰(115k vs 611k)으로 대등한 정확도(82.5% vs 85.8%)를 달성. 반면 생성형 단서(cue_bank)는 토큰은 늘고 정확도는 81.1%로 하락.
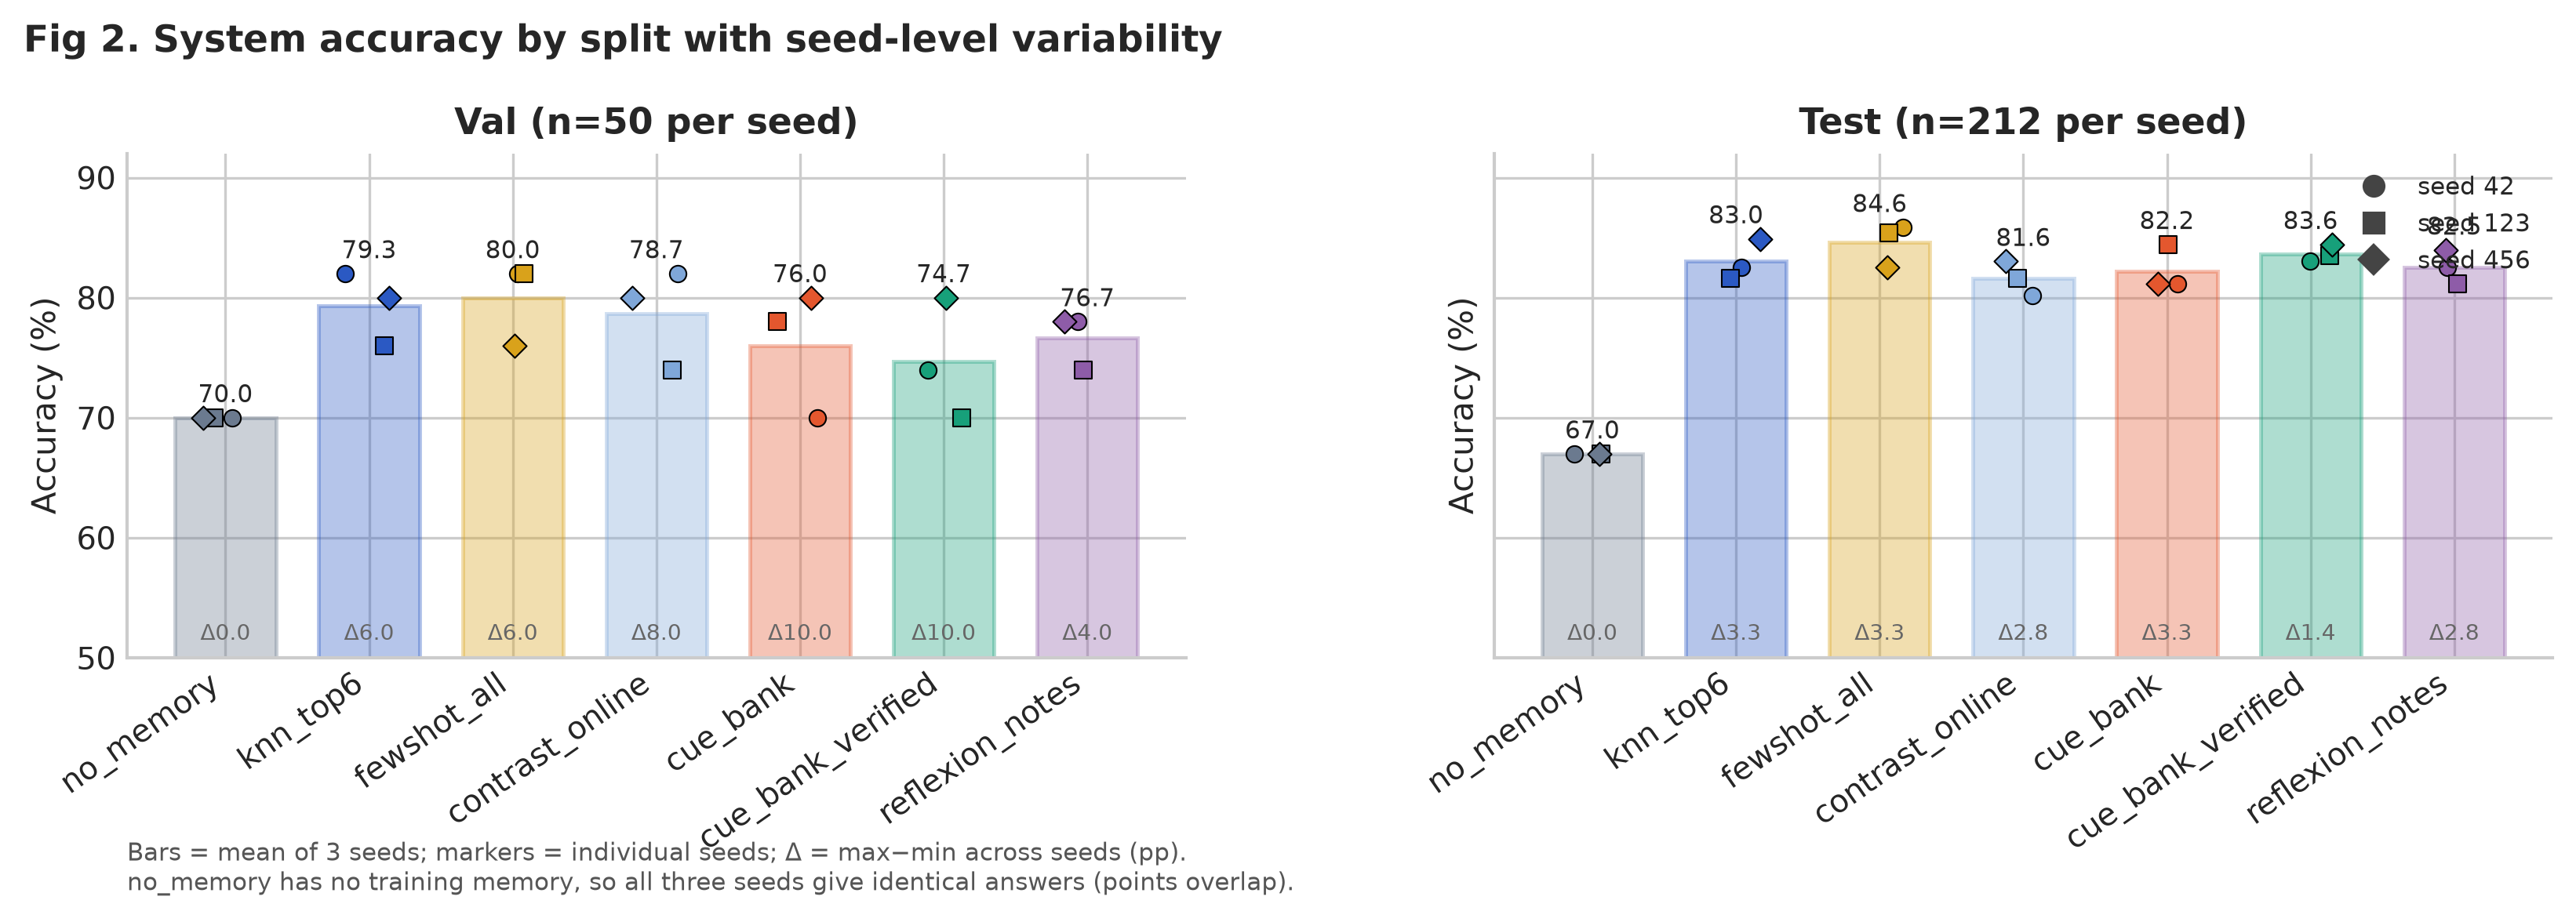
Fig 2: System Performance by Split
Fig 2. 7개 시스템 분할별(Val vs Test) 3개 시드 성능
Validation 50문항에서 나타난 순위(fewshot_all > contrast_online > knn_top6)가 Test 212문항 및 다른 시드(123, 456)에서는 일관되지 않음을 실증.
Matplotlib/Seaborn · N=212 · 3 SeedsC
부록 D · 데이터 시각화 갤러리 (2/4)

부트스트랩 신뢰구간과 표본 크기 역전 효과
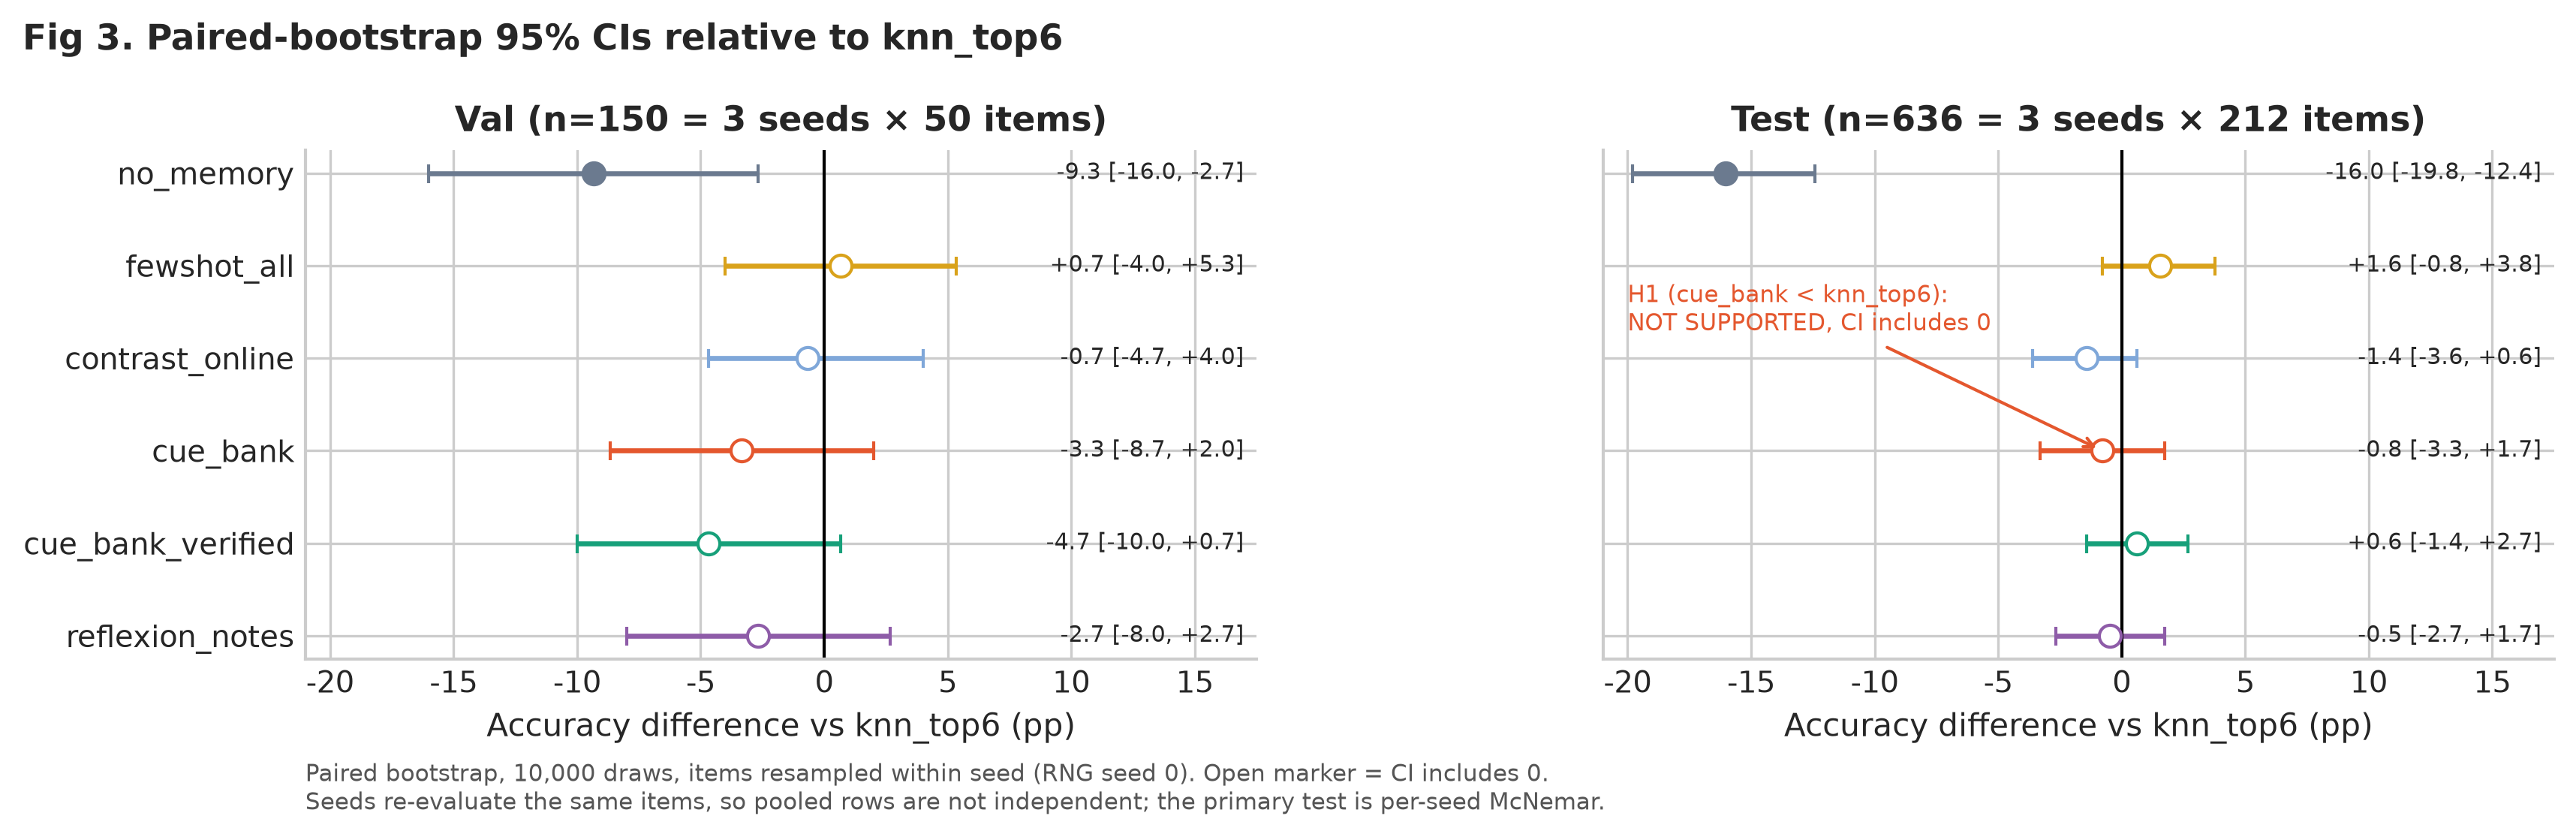
Fig 3: Bootstrap Forest Plot
Fig 3. 10,000회 쌍체 부트스트랩 95% 신뢰구간
test 세트, 세 시드 통합. knn_top6 대비 0을 배제한 것은 no_memory 하나뿐(−16.0%p, 95% CI [−19.8, −12.4]). cue_bank(−0.8%p, [−3.3, +1.7])를 포함한 나머지 다섯 개의 구간은 모두 0을 포함.
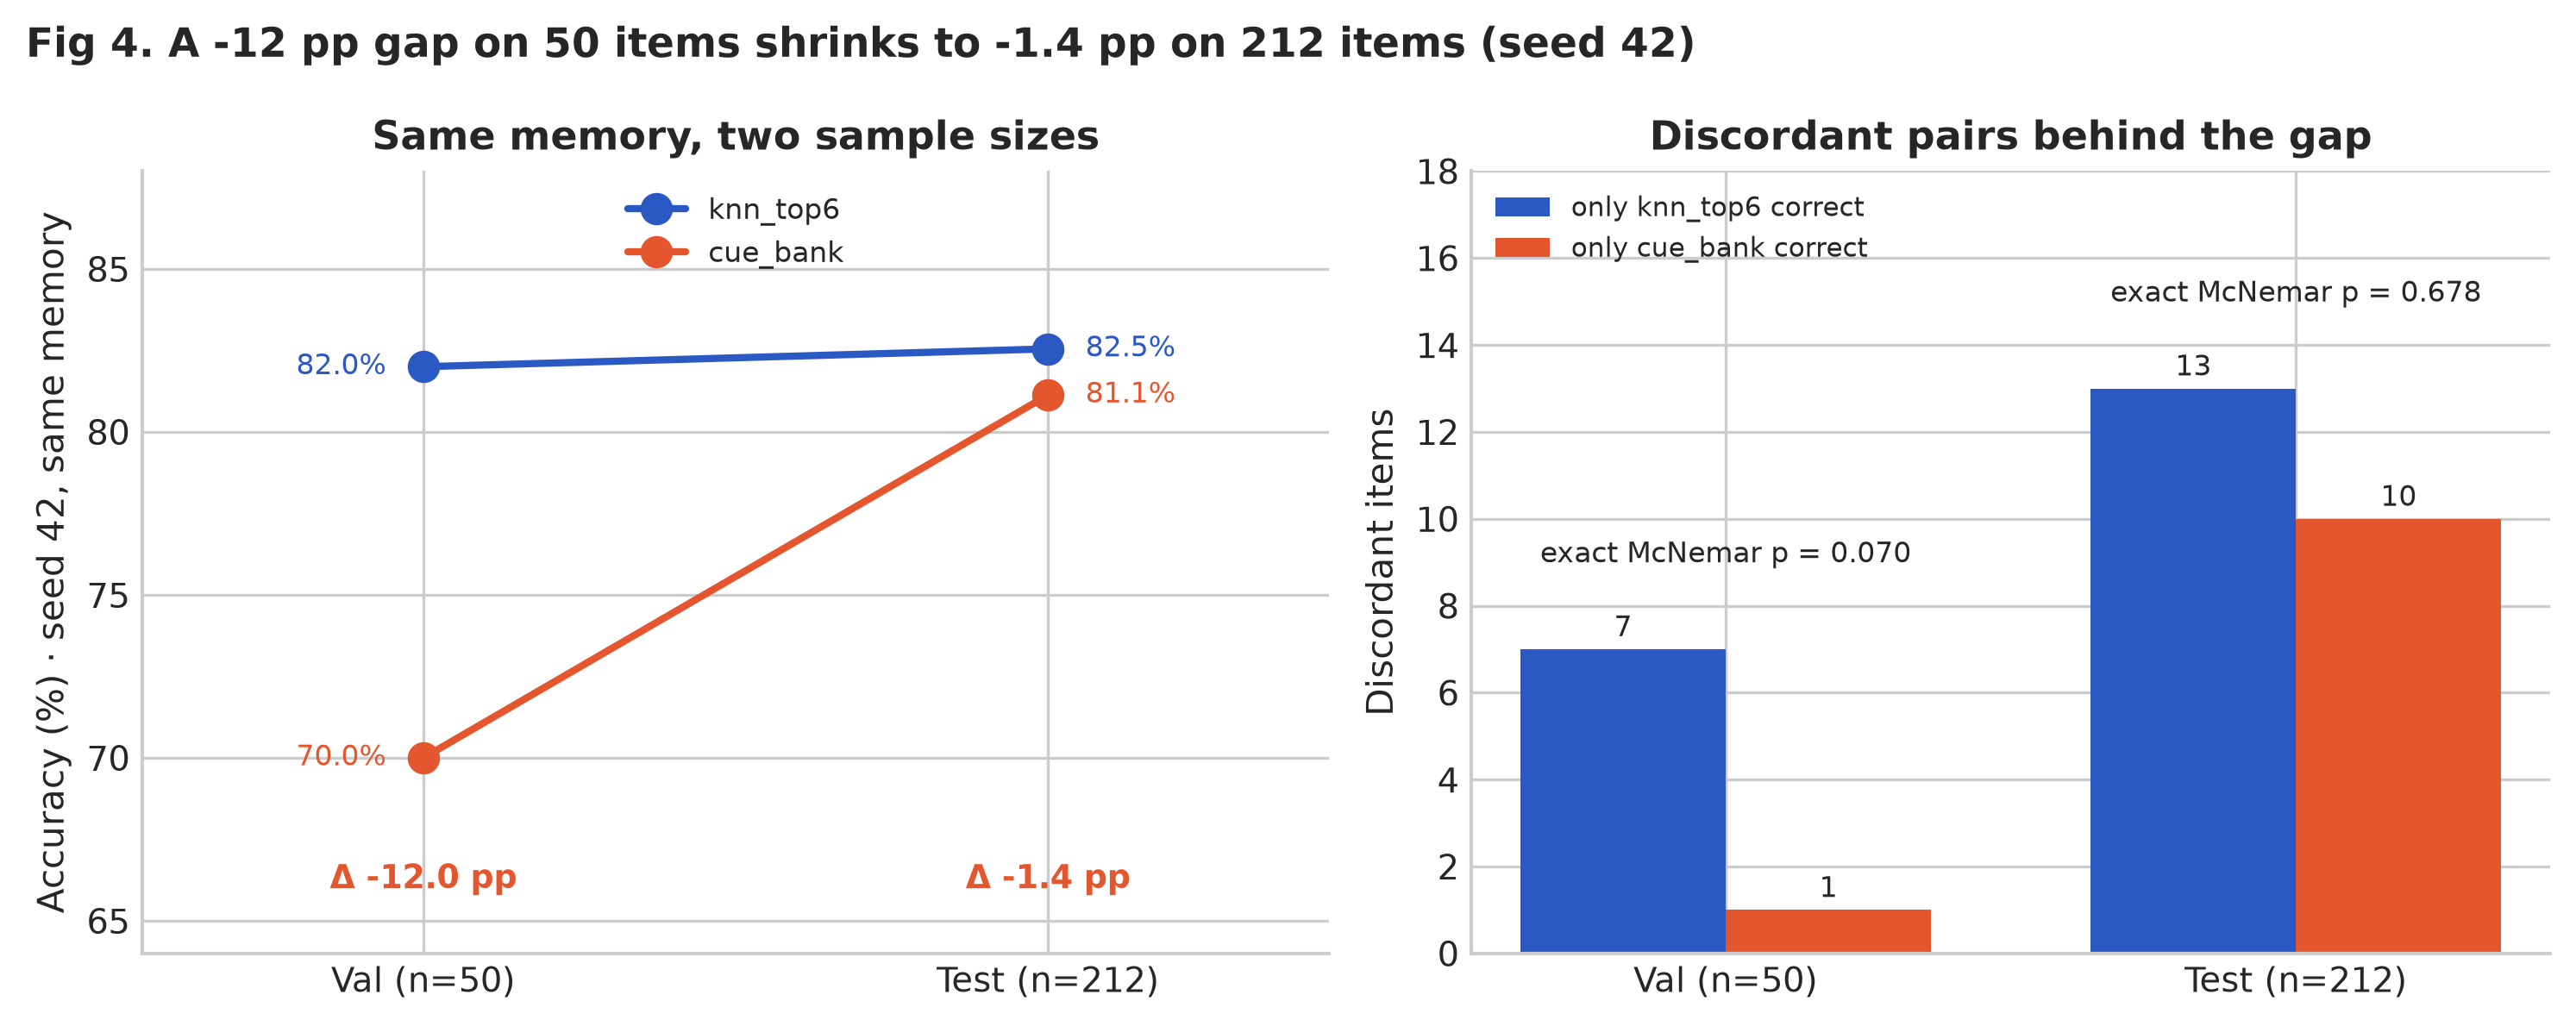
Fig 4: Sample Size Reproducibility
Fig 4. 표본 크기(val n=50 vs test n=212)에 따른 결론 변화
val 50문항에서는 cue_bank가 knn_top6보다 12%p 낮아 보였으나(82.0 vs 70.0, 불일치 7:1, p=0.070), test 212문항에서는 1.4%p 차이(13:10, p=0.678)로 격차가 사라짐. 소표본의 경향을 결론으로 쓰면 안 됨을 보여줌.
10,000 Draws Paired Bootstrap · McNemar Exact TestD
부록 E · 데이터 시각화 갤러리 (3/4)

오차 귀인 로지스틱 회귀와 데이터 사이언스 과제 확장
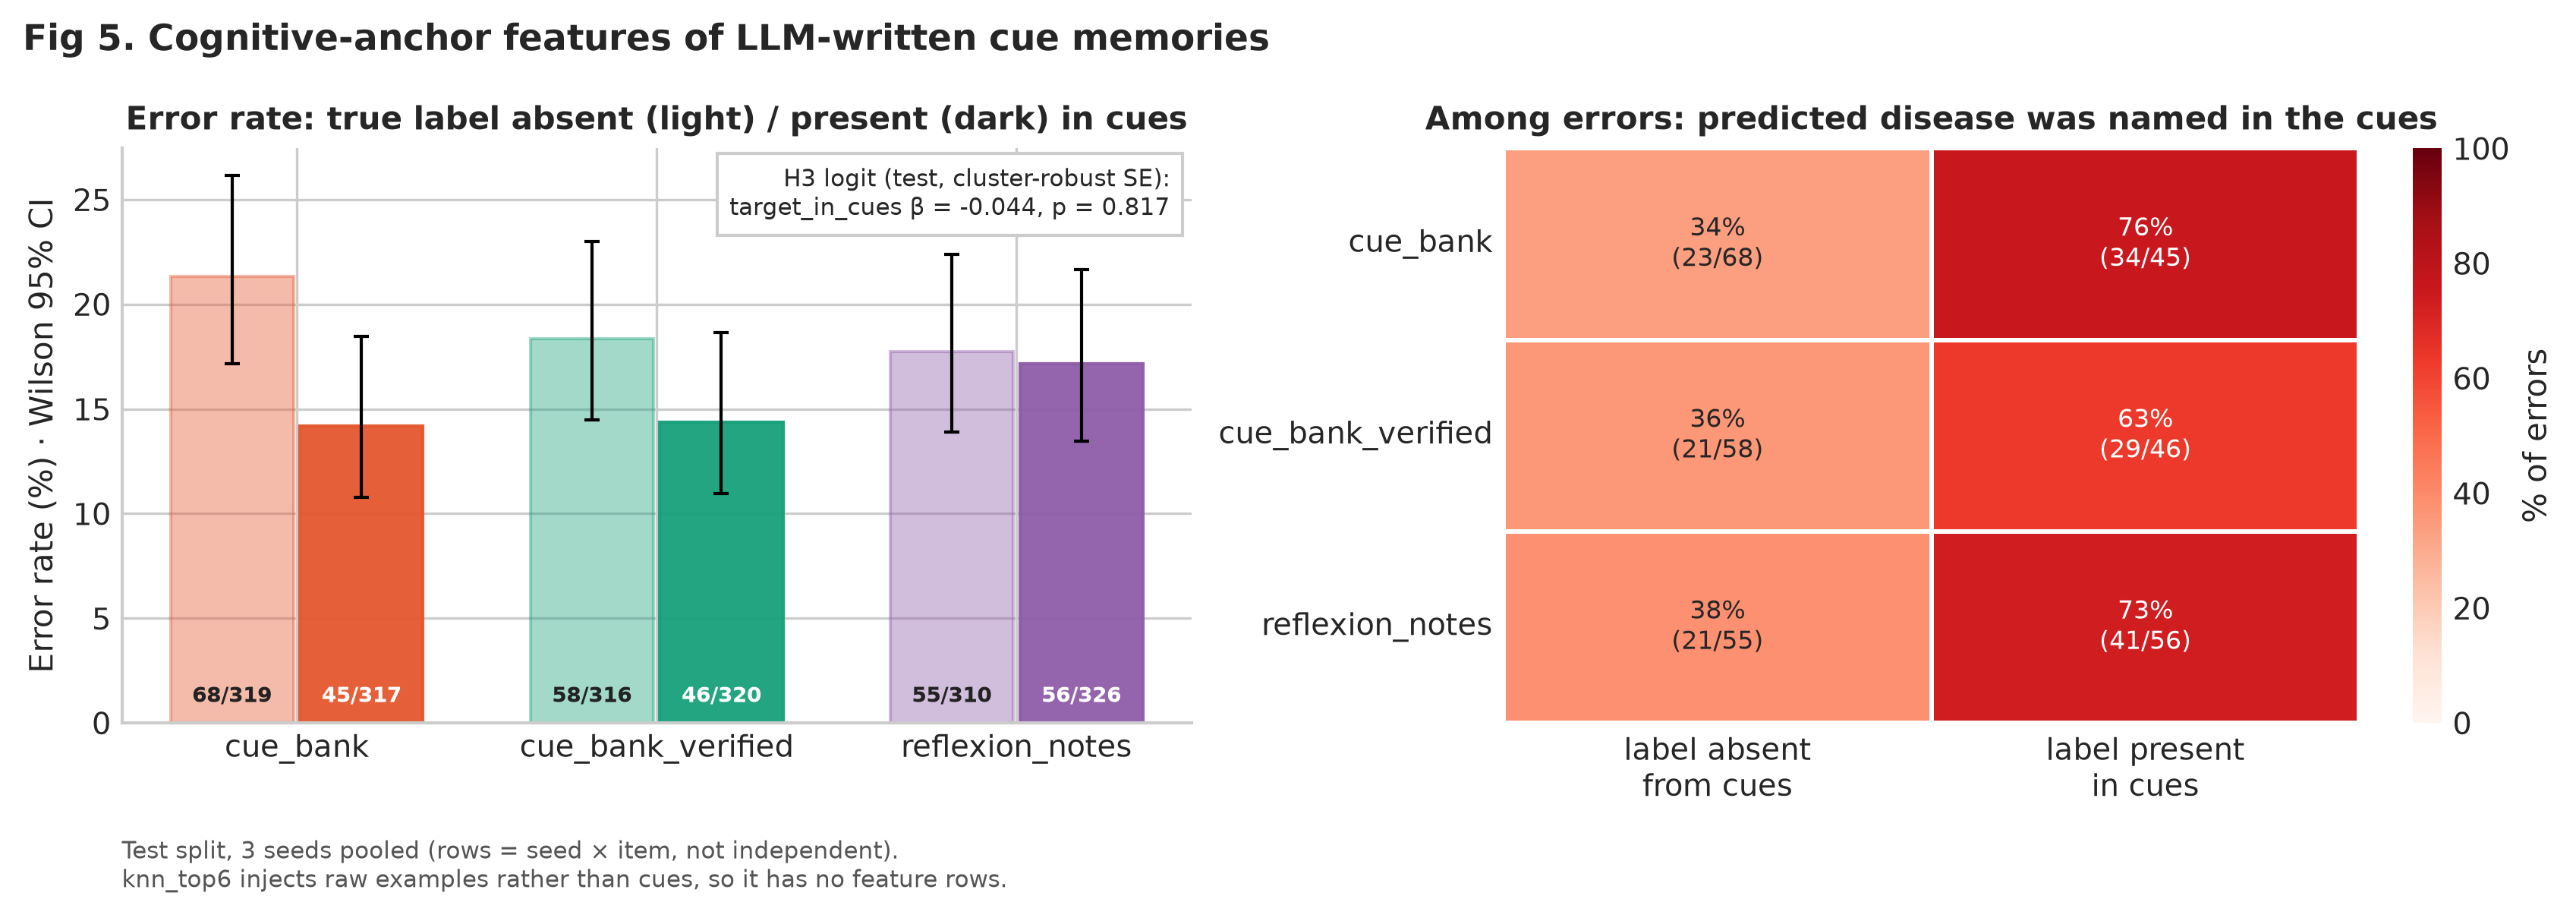
Fig 5: Cognitive Anchor Features
Fig 5. 인지 닻(단서) 피처 로지스틱 회귀 오차 귀인
정답 질병이 단서에 포함된 경우, cue_bank 오답의 76%(34/45)가 단서 속 질병을 예측함(verified 63%, reflexion 73%). 단서에 끌린 흔적은 보이나, 로지스틱 회귀에서 정답률에 대한 효과는 유의하지 않음(β=−0.044, p=0.817).
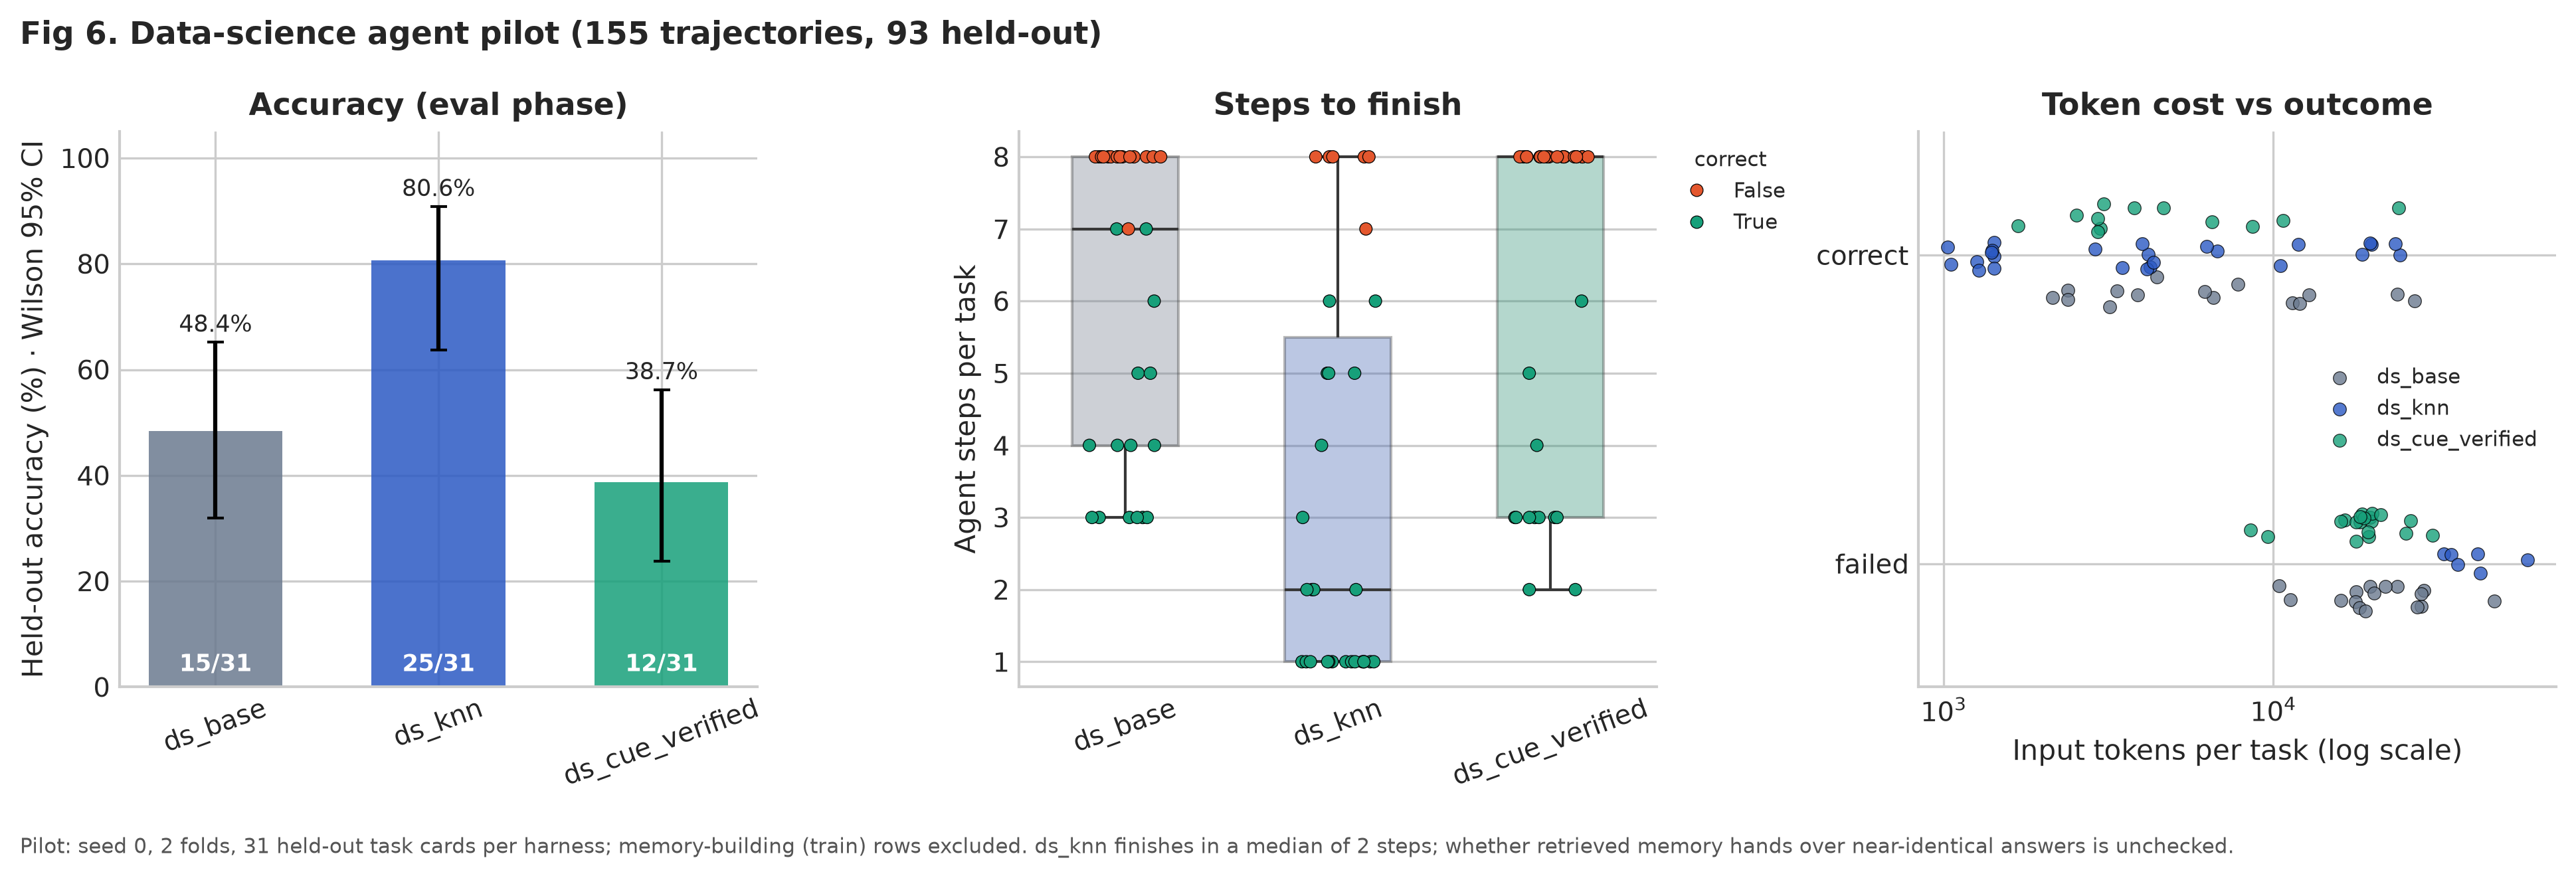
Fig 6: DS Tasks Benchmark
Fig 6. 데이터 사이언스(DS) ReAct 에이전트 31개 카드 벤치마크
텍스트 분류를 넘어 통계 검정, LightGBM, SHAP 분석 등 실제 분석 과제 31개에서 ReAct 루프 메모리 성능 평가(ds_base vs ds_knn vs ds_cue_verified).
Logit Attribution & DS ReAct 2-Fold BenchmarkE
부록 F · 데이터 시각화 갤러리 (4/4)

통계적 검정력 분석과 반복 호출 잡음
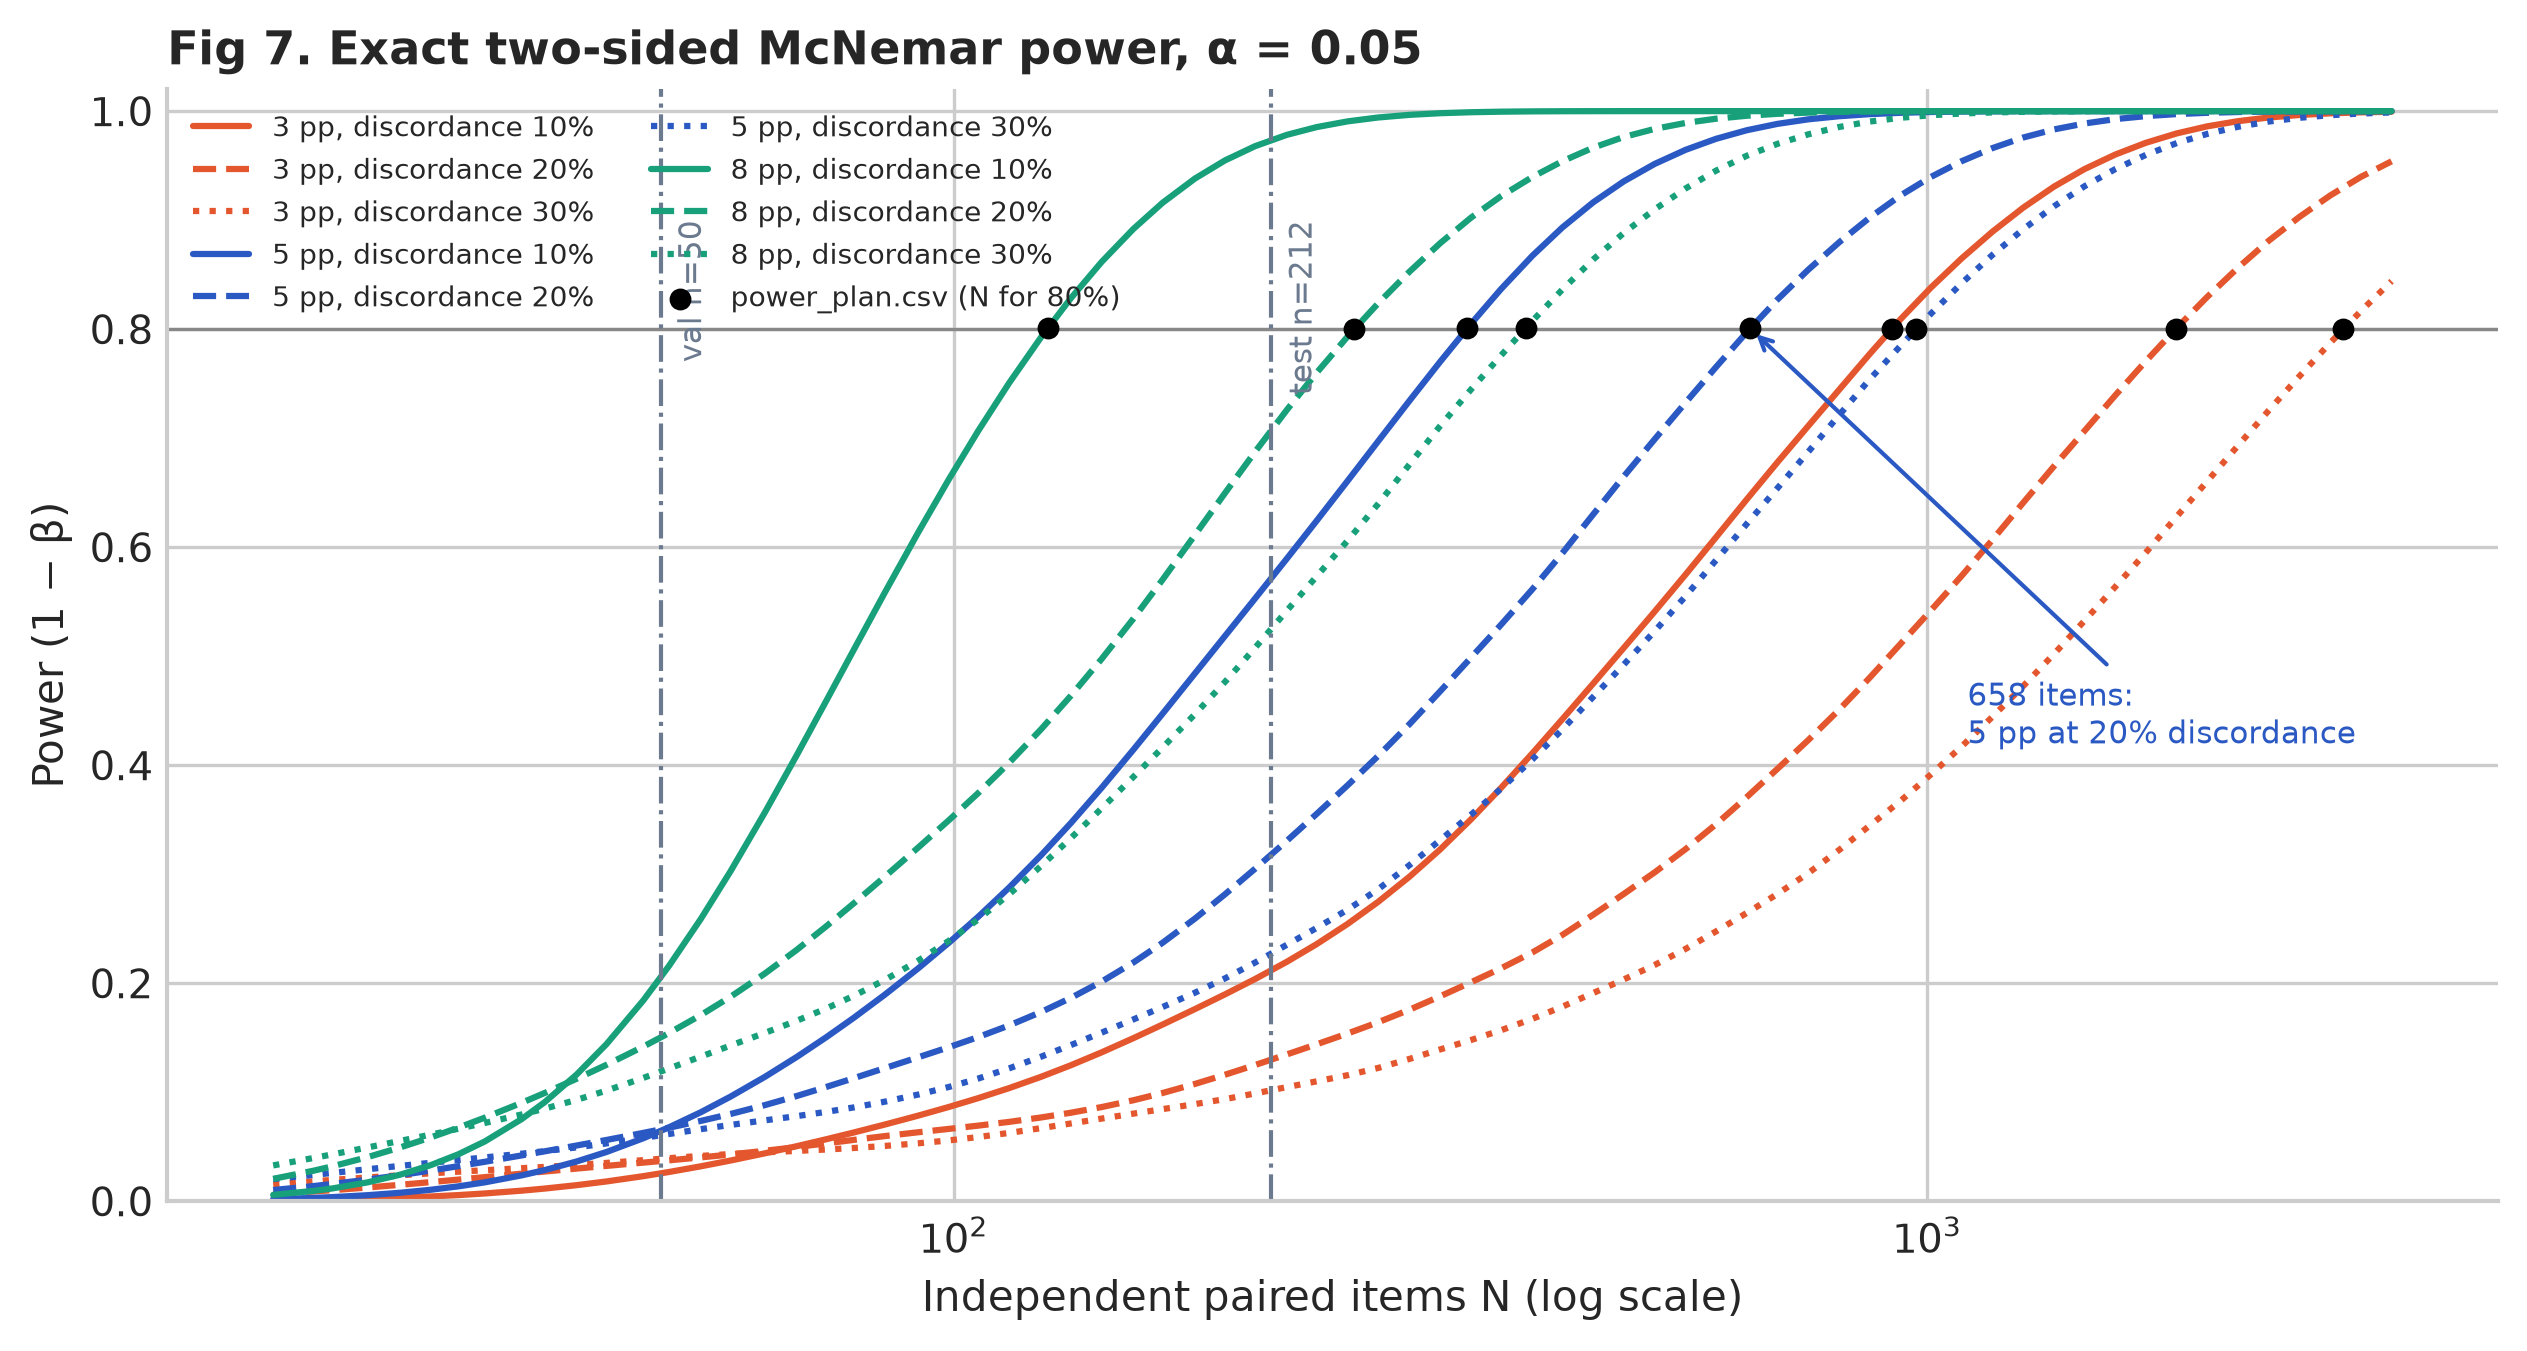
Fig 7: Power Analysis Curve
Fig 7. McNemar 검정 효과 크기별 검정력(Power) 곡선
불일치율 20%를 가정하면, 5%p 차이를 검정력 80%로 검출하는 데 658문항이 필요함. 현재 val 50·test 212문항으로는 5%p 수준의 차이를 가리기 어려움.
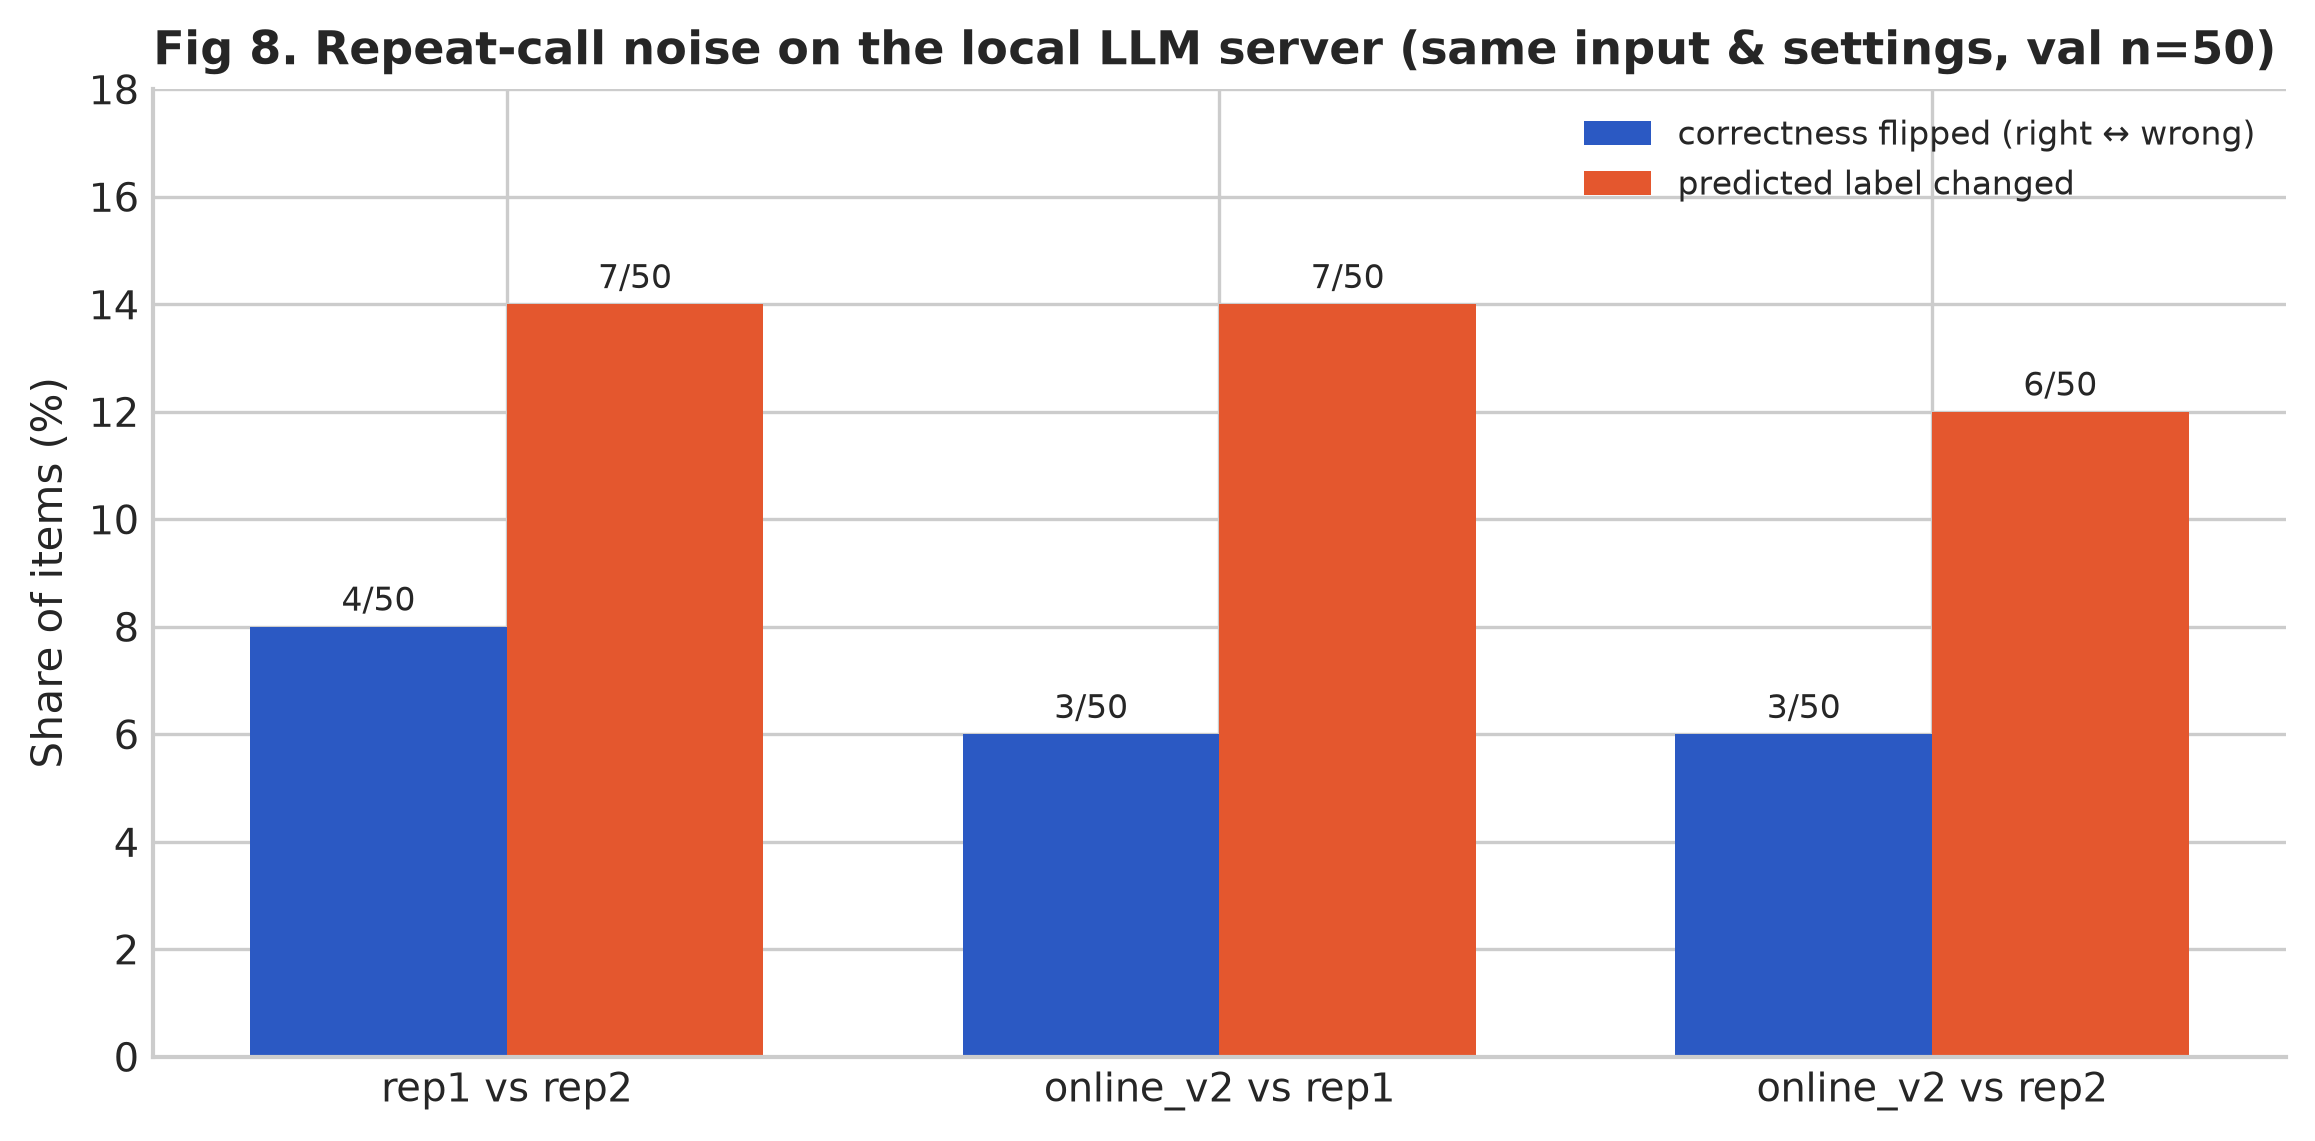
Fig 8: Runtime Stochasticity
Fig 8. 동일 조건 반복 호출의 출력 잡음 (val n=50)
같은 입력·같은 설정으로 다시 호출해도 정오가 3~4문항(6~8%), 예측 라벨이 6~7문항 바뀌는 것을 관찰. 캐시에 고정한 응답으로 재평가하는 이유.
Sample Size Power Plan & Empirical Latency AuditF